Maskinen lærte at svare. Nu skændes vi om, hvad det betyder
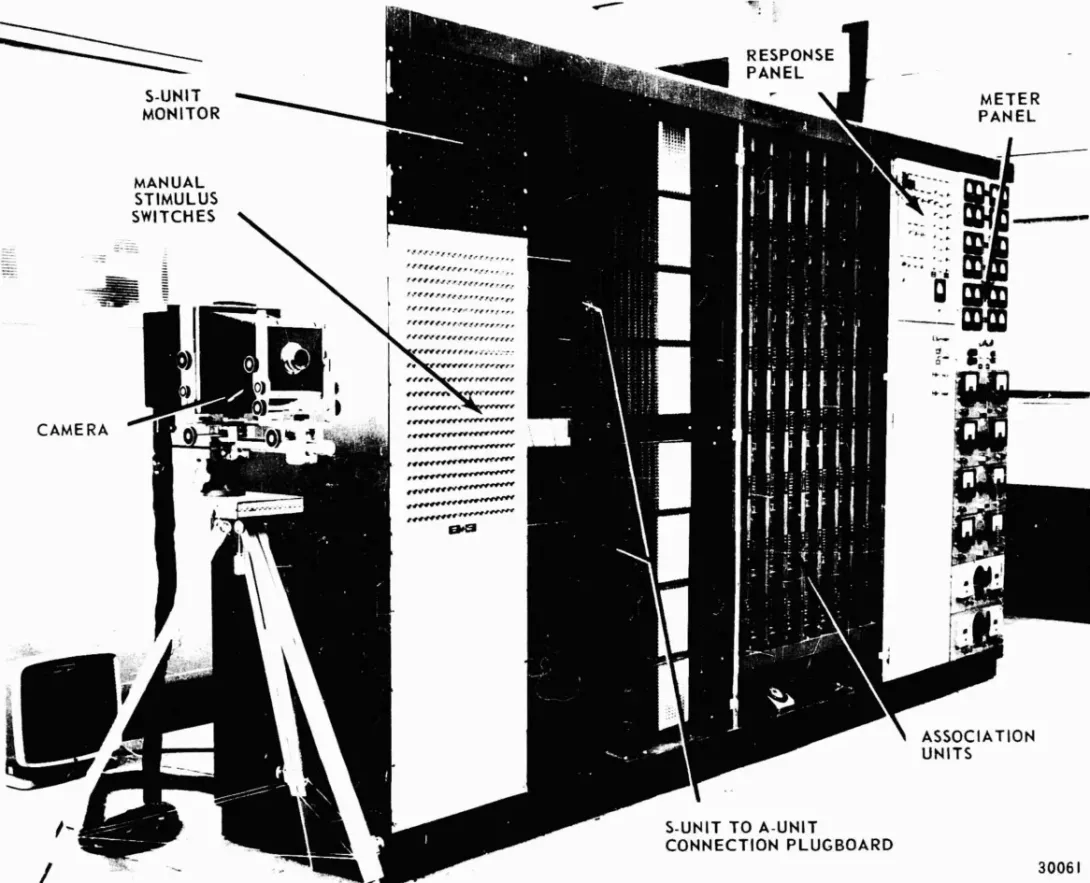
John C. Hay og Albert E. Murray. Mark I Perceptron, figur fra operatørmanualen, 15. februar 1960. Public domain. Wikimedia Commons.
AI begyndte hverken med ChatGPT eller med en maskine, der kunne tænke som os. Fra 1940’ernes kunstige nerveceller til dagens frontiermodeller har forskerne ændret både metoderne og målestokken. Striden mellem Martin Thorborg og Zenia Stampe rammer et gammelt spørgsmål i en ny maskine: Hvad er det egentlig, den har lært?
Martin Thorborg havde fortalt en maskine om sit liv. Nu sad han i Debatten og forklarede, hvordan den havde hjulpet ham med at gøre fortællingen til en bog.
I udsendelsen 29. oktober beskrev han omkring 30 timers indtaling, transskription og brug af Claude som redaktør. Det var hans oplevelser og hans kreative bearbejdning, fremhævede han. Zenia Stampe pegede på noget længere tilbage: Sprogmodellen var allerede udviklet med menneskers værker som en del af sit grundlag.1
Det er en forskel mellem materialet, man giver en model, og den træning, der har gjort modellen anvendelig. Den forskel kan godt eksistere, samtidig med at man er uenig om kunst, ophavsret og støtte til kultur.
For at forstå den skal vi tilbage til en tid, hvor kunstig intelligens endnu ikke havde fået sit navn.
Før navnet kom spørgsmålet
I 1943 beskrev Warren McCulloch og Walter Pitts, hvordan stærkt forenklede modeller af nerveceller kunne forbindes og udføre logiske beregninger. De havde ikke bygget en menneskehjerne. De havde vist en matematisk forbindelse mellem et netværks opbygning og det, det kunne beregne.2
Syv år senere tog Alan Turing fat på spørgsmålet om tænkende maskiner. Men hans berømte artikel begyndte med at gøre selve spørgsmålet til et problem: Hvad mener vi med at tænke?
Han foreslog at undersøge en maskines adfærd gennem et imitationsspil med skriftlig kommunikation. Kunne dens svar gøre den vanskelig at skelne fra et menneske? Det flyttede opmærksomheden fra en uhåndterlig definition til noget, man kunne afprøve.3
Den forskel følger os stadig. En overbevisende samtale er en præstation, vi kan undersøge. Hvad den fortæller om indre oplevelse, er et andet spørgsmål.
Navnet kom i et projektforslag dateret 31. august 1955. John McCarthy, Marvin Minsky, Nathaniel Rochester og Claude Shannon ville samle forskere på Dartmouth den følgende sommer. De kaldte arbejdet artificial intelligence.
Forslaget byggede på en dristig formodning: Aspekter af læring og intelligens kunne beskrives så præcist, at en maskine kunne efterligne dem. Sprog og neurale netværk var allerede på programmet. Sommeren 1956 blev et samlingspunkt for det navngivne forskningsfelt, ikke begyndelsen på alle dets idéer.4
To veje ind i maskinen
En vigtig tilgang blev at skrive viden og regler ind i programmerne. Hvis bestemte betingelser var opfyldt, skulle systemet drage en bestemt slutning.
I 1970’ernes ekspertsystemer blev menneskelige specialisters viden gjort til et centralt råstof. Edward Feigenbaum beskrev i 1977 arbejdet med at indsamle, repræsentere og anvende ekspertviden, så maskiner kunne ræsonnere inden for afgrænsede fagområder.5
En anden tilgang var at lade systemet tilpasse sig eksempler. Frank Rosenblatts perceptron fra 1950’erne hører til den historie. I hans artikel fra 1958 blev læring knyttet til ændringer i et netværks forbindelser og deres betydning for dets svar.6
Intelligens kunne altså både være noget, programmøren forsøgte at beskrive som regler, og noget, man forsøgte at frembringe gennem læring. De to spor har eksisteret ved siden af hinanden. Historien er ikke en stafet, hvor én metode forsvandt, hver gang en anden fik succes.
Den talende maskine var engang en regelbog
I 1966 beskrev Joseph Weizenbaum ELIZA. Programmet kunne føre en skriftlig samtale ved at finde nøgleord og bruge regler til at omforme brugerens sætninger. Det kendte DOCTOR-script gav samtalen form som et møde med en psykoterapeut.7
Rollen var snedigt valgt. Et modspørgsmål kunne få en enkel tekstregel til at ligne eftertænksomhed. Det var ikke nødvendigt, at programmet havde en samlet forståelse af det liv, brugeren beskrev.
Allerede i artiklens indledning beskrev Weizenbaum en tilbagevendende reaktion på intelligente programmer: Når mekanismen blev forklaret, forsvandt magien, og maskinen blev flyttet over blandt de forståelige kuriositeter.
Det er en sær målestok. Før vi ved, hvordan noget virker, kan det ligne intelligens. Når vi har forstået mekanismen, kan vi blive tilbøjelige til at tage betegnelsen fra det igen.
ELIZA viser, hvor meget en samtales form kan gøre. Dagens sprogmodeller har en langt mere omfattende læringsmekanisme og et langt bredere repertoire. Det fælles tekstfelt på skærmen kan skjule forskellen.
Da verdensmesteren tabte, var navnet stadig til diskussion
I 1997 besejrede IBM’s Deep Blue den regerende verdensmester Garry Kasparov i en skakmatch. Maskinen kombinerede blandt andet specialiseret hardware, søgning gennem mulige træk og vurdering af stillinger.8
Samme år kritiserede forskeren Richard Korf IBM’s svar på et spørgsmål på virksomhedens hjemmeside: Brugte Deep Blue kunstig intelligens? Ifølge Korf lød svaret nej.
Korf mente, at IBM dermed gjorde AI alt for snævert til et spørgsmål om at efterligne menneskers tankeproces. Maskinen spillede anderledes end et menneske, men brugte metoder fra AI-forskningen. Han advarede også mod, at feltets succeser fik deres egne navne og efterlod AI med løfterne og fiaskoerne.9
Korf mindede om, at løftet om at slå verdensmesteren inden for ti år var blevet gentaget fra omkring 1960. De store forventninger havde også skabt mistillid, når resultaterne udeblev.9
Maskinen lærte at finde mønstrene
Læring i neurale netværk fik et vigtigt skub med Rumelhart, Hinton og Williams’ artikel om backpropagation i 1986. Metoden bruger fejl i resultatet til at beregne, hvordan netværkets vægte skal justeres. Artiklen var et centralt bidrag til flerlagsnetværkenes udvikling; den var ikke opfindelsen af alle idéerne bag metoden.10
Et synligt gennembrud kom i 2012 med billedgenkendelsessystemet, der blev kendt som AlexNet. Store billeddatasæt, et dybt netværk og effektiv brug af grafikprocessorer blev kombineret til markant bedre resultater i ImageNet-konkurrencen.11
I stedet for at mennesker skulle beskrive hvert relevant billedtræk, kunne netværket lære nyttige repræsentationer gennem træning. Mere data og større regnekraft gjorde en gammel forskningsretning langt stærkere.
Men billedgenkendelse var ikke det samme som en samtalende generalist.
I 2017 præsenterede forskere transformerarkitekturen i artiklen Attention Is All You Need. Udgangspunktet var maskinoversættelse. Attention-mekanismer gjorde det muligt at beregne, hvilke dele af input der var relevante for hinanden, og arkitekturen kunne trænes mere parallelt end de tilbagevendende netværk, den blev sammenlignet med.12
Attention er her en beregningsmetode. Ordet betyder ikke, at modellen har menneskelig opmærksomhed. Men metoden blev en afgørende byggesten i udviklingen af store sprogmodeller.
Den store forandring lå også i, hvad brugeren skulle gøre
En autoregressiv sprogmodel trænes blandt andet på at forudsige den næste token: et ord, en del af et ord eller et andet teksttegn. Træningen justerer modellens talværdier, dens vægte.
For at løse opgaven lærer den mønstre i sprog og indhold. Den kan bruge mønstrene til andre opgaver end at fortsætte den tekst, den blev trænet på.
Med GPT-3 viste forskerne i 2020, hvordan instruktioner og eksempler i selve inputtet kunne få den samme grundmodel til at udføre mange forskellige sprogopgaver. I de forsøg blev modellens vægte ikke opdateret, hver gang den fik en ny opgave.13
Det er en vigtig forskel i daglig tale om at træne sin AI. At give en færdig model mails, et manuskript eller stilprøver som kontekst er noget andet end at grundtræne modellen. Det er også noget andet end finjustering, hvor vægtene faktisk ændres. Tv-udvekslingen fortæller ikke tilstrækkeligt om Thorborgs opsætning til, at vi kan afgøre, hvilke tekniske greb han brugte.
En anden del af gennembruddet var eftertræning. I arbejdet med InstructGPT viste forskere i 2022, hvordan menneskers eksempler og vurderinger af svar kunne bruges til at gøre modeller bedre til at følge instruktioner.14
Da ChatGPT blev lanceret 30. november samme år, mødte offentligheden en model tilpasset dialog i en enkel samtalegrænseflade. Årtiers forskning fik en indgang, som ikke krævede, at brugeren kunne programmere.15
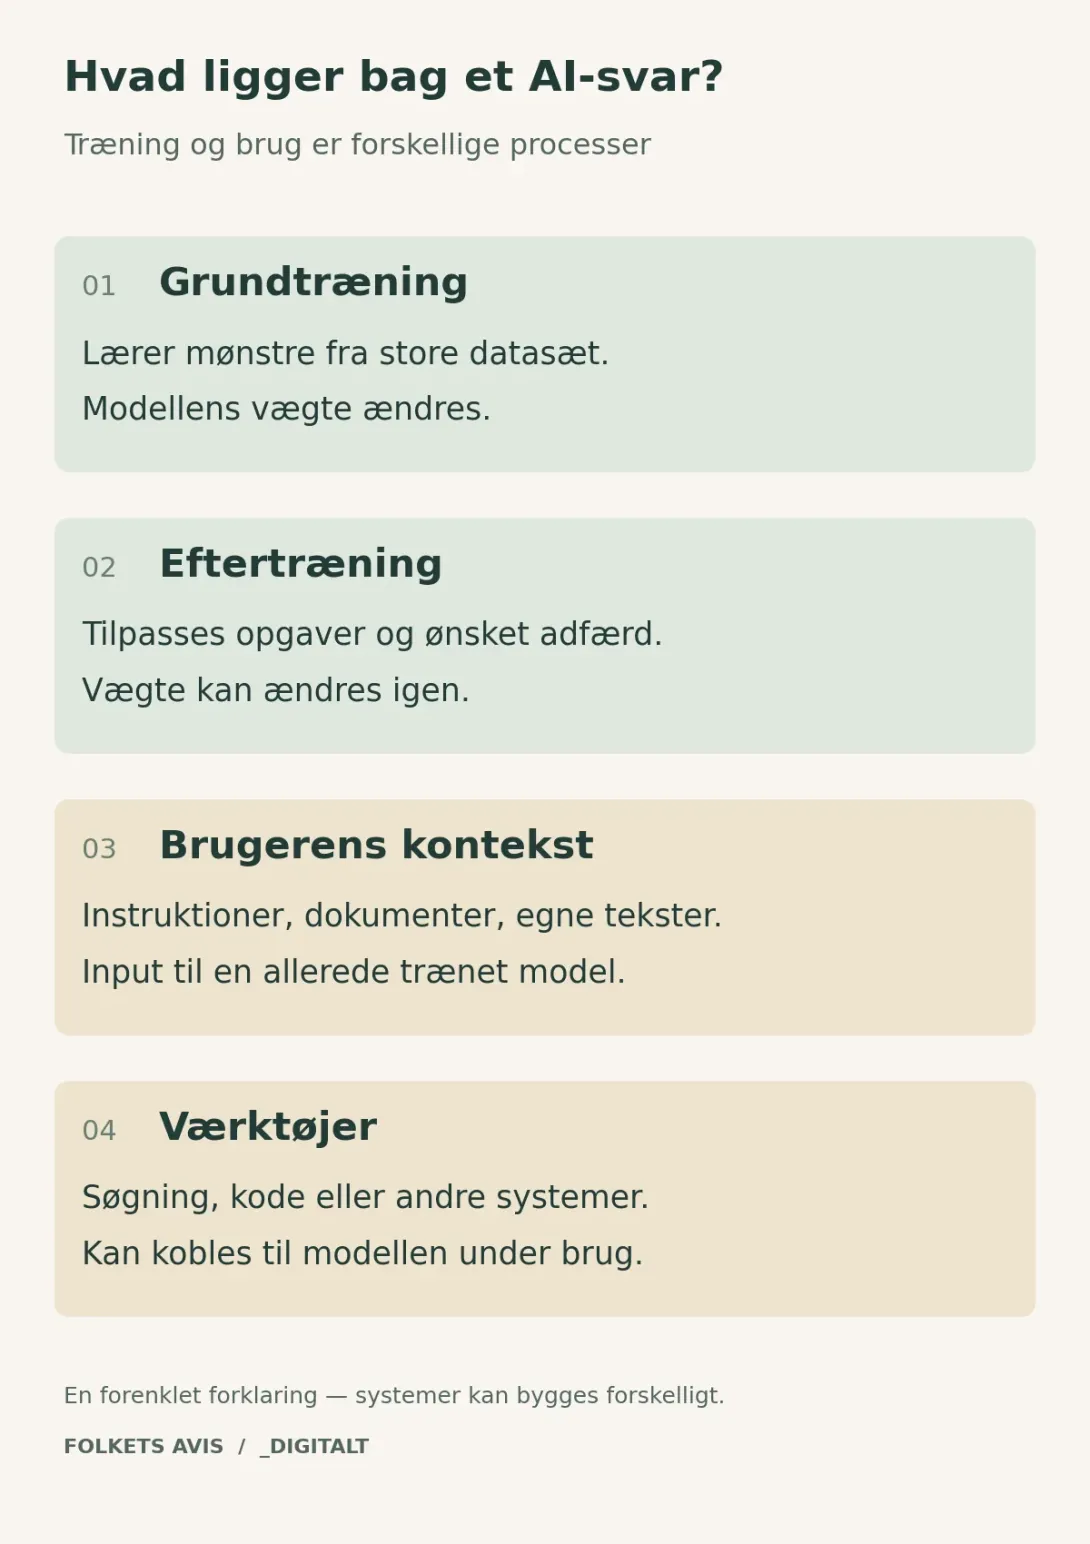
Grafik: Folkets Avis. Begreber efter Brown m.fl. 2020 og Ouyang m.fl. 2022. Datagrundlag.
Fra at svare til at arbejde videre
Udviklingen stoppede ikke ved større modeller og et chatvindue.
Med o1 beskrev OpenAI i september 2024 en retning, hvor forstærkningslæring skulle forbedre løsning af komplekse opgaver, og hvor mere beregning før det endelige svar kunne forbedre resultaterne. Et system kunne bruge flere mellemtrin frem for straks at levere en kort fortsættelse.16
Det, branchen kalder reasoning, betegner her en måde at træne og bruge modeller på. Ordet afgør ikke, om processen er den samme som menneskers bevidste overvejelse.
I efteråret 2026 omfatter frontierfeltet blandt andet OpenAI’s GPT-6-familie, Anthropics Claude Opus 5.5 og Googles Gemini 4 Carbon. Leverandørernes beskrivelser lægger vægt på flere inputformer, programmering, værktøjsbrug og længere opgaveforløb. Google præsenterede Carbon 28. oktober, dagen før Debatten.17
Frontier er en betegnelse for den aktuelle front blandt de mest kapable modeller. Den betegner hverken én bestemt arkitektur eller en entydig erklæring om AGI.
Et AI-system kan nu kombinere modellen med søgning, kodekørsel og andre værktøjer. Når systemet selv vælger flere skridt inden for en opgave, omtales det ofte som en agent. Dermed afhænger resultatet også af de værktøjer, data og tilladelser, systemet har fået. Et flot enkeltstående svar og et pålideligt arbejdsforløb er forskellige præstationer.
Ét navn, flere historiske målestokke
| Nedslag | Hvad rykkede sig? | Spørgsmålet bag teknologien |
|---|---|---|
| 1950: Turing | Samtalen som afprøvning | Hvordan undersøger vi intelligent adfærd? |
| 1955–56: Dartmouth | Et forskningsfelt fik navn | Kan intelligens beskrives, så den kan simuleres? |
| 1966: ELIZA | Regler kunne skabe en samtales form | Hvor meget lægger mennesket selv ind i svaret? |
| 1997: Deep Blue | Specialiseret AI slog verdensmesteren | Skal maskinen arbejde som os for at tælle som intelligent? |
| 2012–17: Dybe netværk og transformer | Læring og arkitektur gav nye muligheder | Hvad kan systemet lære af data? |
| 2020–22: Store sprogmodeller og chat | Mange opgaver kunne bestilles med sprog | Hvad kan den samme model bruges til? |
| 2024–26: Reasoning og agenter | Mere beregning og værktøjer udvider opgaven | Hvor pålideligt kan systemet arbejde over flere skridt? |
Tabellen viser udvalgte nedslag, ikke en ubrudt vej mod ét på forhånd bestemt mål. Specialiserede systemer, regler og læring bruges fortsat side om side.
Hvad historien kan hjælpe os med at skændes om
Tilbage i Debatten er det derfor nyttigt at skille spørgsmålene ad.
Et handler om funktion: Kan modellen hjælpe Thorborg med at bearbejde hans fortælling? Et andet handler om grundlaget: Hvilket materiale har gjort den i stand til det? Et tredje handler om værdi og rettigheder: Hvem skal krediteres, betales eller støttes?
En beskrivelse af teknikken kan gøre de spørgsmål skarpere. Den kan ikke alene afgøre, hvad et samfund bør belønne som kunst.
Modeller kan generalisere ud over træningseksemplerne. De kan også gengive materiale fra træningen; forskere har eksempelvis demonstreret udtræk af ordrette tekstsekvenser fra GPT-2. Hverken en god ny formulering eller en sådan demonstration afgør ophavsretten til enhver brug af en nutidig model.18
Og når en maskine bliver mere anvendelig, bliver de menneskelige valg omkring den mere betydningsfulde. Hvem vælger opgaven, vurderer svaret og opdager, hvis et tilsyneladende godt resultat bygger på en forkert præmis? Det spørgsmål har vi også undersøgt i historien om eksperternes AI, der havde fået en hemmelig besked.
I 1955 ville forskerne beskrive intelligens præcist nok til at simulere den. I 2026 kan vi bede en maskine om at hjælpe med en bog, uden først at blive enige om, hvad intelligens betyder.
Det er et teknologisk gennembrud. Det er også grunden til, at skænderiet er flyttet fra laboratoriet og ind i vores fælles kulturliv.
DR, Debatten: Kunstig intelligens, kunstig kultur?, 29. oktober 2026. Beskrivelserne bygger på udsendelsens offentlige undertekster, især ca. 14:51–18:59. Udvekslingen er gengivet i referat. ↩
McCulloch og Pitts, A Logical Calculus of the Ideas Immanent in Nervous Activity, 1943, s. 115–133. Den forenklede neuronmodel er en matematisk konstruktion. ↩
Turing, Computing Machinery and Intelligence, Mind, 1950, s. 433–460. Linket gengiver artiklens indledning og imitationsspil. ↩
McCarthy, Minsky, Rochester og Shannon, A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence, dateret 31. august 1955, til projektet sommeren 1956. ↩
Feigenbaum, The Art of Artificial Intelligence: Themes and Case Studies of Knowledge Engineering, IJCAI, 1977. Artikelforfatterens resumé beskriver indsamling, repræsentation og anvendelse af ekspertviden. ↩
Rosenblatt, The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain, Psychological Review 65(6), 1958, s. 386–408. ↩
Weizenbaum, ELIZA — A Computer Program for the Study of Natural Language Communication Between Man and Machine, Communications of the ACM, januar 1966. ↩
Campbell, Hoane og Hsu, Deep Blue, Artificial Intelligence 134, 2002, s. 57–83. Udviklernes beskrivelse af skakcomputeren og matchsejren i 1997. ↩
Korf, Does Deep Blue Use AI?, AAAI Technical Report WS-97-04, 1997. IBM’s daværende websvar er gengivet gennem Korfs samtidige kritik. ↩ ↩
Rumelhart, Hinton og Williams, Learning Representations by Back-Propagating Errors, Nature 323, 1986, s. 533–536. ↩
Krizhevsky, Sutskever og Hinton, ImageNet Classification with Deep Convolutional Neural Networks, 2012. Artiklen beskriver også vinderbidraget til ILSVRC-2012. ↩
Vaswani m.fl., Attention Is All You Need, indsendt 12. juni 2017. Arkitekturen blev præsenteret til sekvensomformning med forsøg i maskinoversættelse. ↩
Brown m.fl., Language Models Are Few-Shot Learners, 2020, især afsnit 2 om grundtræning, finjustering og eksempler i konteksten. Tilpasning via input og ændring af modellens vægte skelnes udtrykkeligt. ↩
Ouyang m.fl., Training Language Models to Follow Instructions with Human Feedback, 2022. InstructGPT-arbejdet kombinerer demonstrationer, menneskers rangordning af svar og forstærkningslæring. ↩
OpenAI, Introducing ChatGPT, 30. november 2022. Lanceringen beskriver en dialogtilpasset model fra GPT-3.5-serien. ↩
OpenAI, Learning to Reason with LLMs, 12. september 2024. Beskrivelsen og resultaterne er leverandørens egne. ↩
Eksempler kontrolleret 2. november 2026: OpenAI, GPT-6 and Intelligent UI for Everyone, 7. oktober 2026; Anthropic, Introducing Claude Opus 5.5, 22. september 2026; Google, Gemini 4 Carbon: Our Next Frontier Model, 28. oktober 2026. Det er leverandørernes beskrivelser, ikke en uafhængig rangliste. ↩
Carlini m.fl., Extracting Training Data from Large Language Models, indsendt 2020, revideret 2021. Forsøget udtrækker tekst fra GPT-2 og måler ikke alle nutidige modellers tilbøjelighed til at gengive træningsmateriale. ↩